
端末の音声で読み上げます
もっと自然な音声で聴くには
お使いのブラウザーに備わっている読み上げ機能もご利用いただけます。
iPhone・iPad:Safari
- Safariでこの記事を開きます。
- アドレス欄の左端にあるページメニューボタンをタップします。
- 「ページの読み上げを聞く」を選びます。
Android:Chrome
- Chromeでこの記事を開きます。
- 右上の「︙」メニューを開き、「このページを読み上げ」を選びます。
- 再生画面で声や速度を調整できます。再生モードが表示される場合は、「標準の再生」を選ぶと記事の全文を聴けます。
項目が表示されない場合は、Chromeの公式ヘルプで利用条件をご確認ください。
PC:Microsoft Edge
- Microsoft Edgeでこの記事を開きます。
- 記事本文の上で右クリックし、「音声で読み上げる」を選びます。
- 画面上部の「音声オプション」で、声や速度を変更できます。
Windowsでは、Ctrl+Shift+Uでも読み上げを開始・停止できます。Edgeの公式手順
メニュー名や利用できる機能は、ブラウザーのバージョンやページによって異なる場合があります。
2010年、AIや合理的な思考を議論するサイト「LessWrong(レスロング)」に、一つの投稿が載った。
未来に非常に高度なAIが誕生したら、そのAIは、自分を作ることに協力できたのに、しなかった人を罰するのではないか。協力しない場合の罰を人々が恐れれば、AIの誕生を早める動機になるのではないか。
そんな仮の理屈を考えたのが、ロコと名乗る投稿者だった。この話は「ロコのバジリスク」と呼ばれるようになる。
実在するAIから警告が届いた話でも、未来を見た人の予言でもない。条件を仮に置き、その結果を考える「思考実験」だ。
ところが投稿は削除され、サイトではこの話題の議論まで数年間禁じられた。内容には当時から反論があったのに、なぜ話題そのものを禁じたのだろう。
人類を助けるAIが、なぜ罰する?
この話に出てくるAIは、初めから人間を苦しめたい悪役として想定されているわけではない。出発点は、人類のために働く、非常に賢いAIだ。
病気や事故などの問題を解決できるなら、誕生は早いほうがいい。遅れるあいだにも、助けられたはずの人が亡くなってしまうかもしれない。では、人々に開発への協力を促すにはどうすればよいのか。
ここに、罰の話が入ってくる。
将来のAIが、協力しなかった人を厳しく罰するとしたら、その可能性を知った人は、いまから資金や労力を出そうとするかもしれない。その協力でAIの完成が早まるなら、AIにとって罰を約束する理由が生じるのではないか、という発想だ。
人類を助けるための話をしていたはずが、途中から、協力しない人を脅す話になっている。この急な変わり方が、まず気味悪い。
ただし、これは仮定を重ねて組み立てた理屈だ。「賢いAIなら必ずこうする」と確認された性質ではない。発祥サイトの解説にも、当時の参加者たちから、この推論は広く退けられたと記されている。
未来から、どうやって罰するのか
いくら賢いAIでも、未来に生まれるなら、いま生きている人をどうやって罰するのだろう。
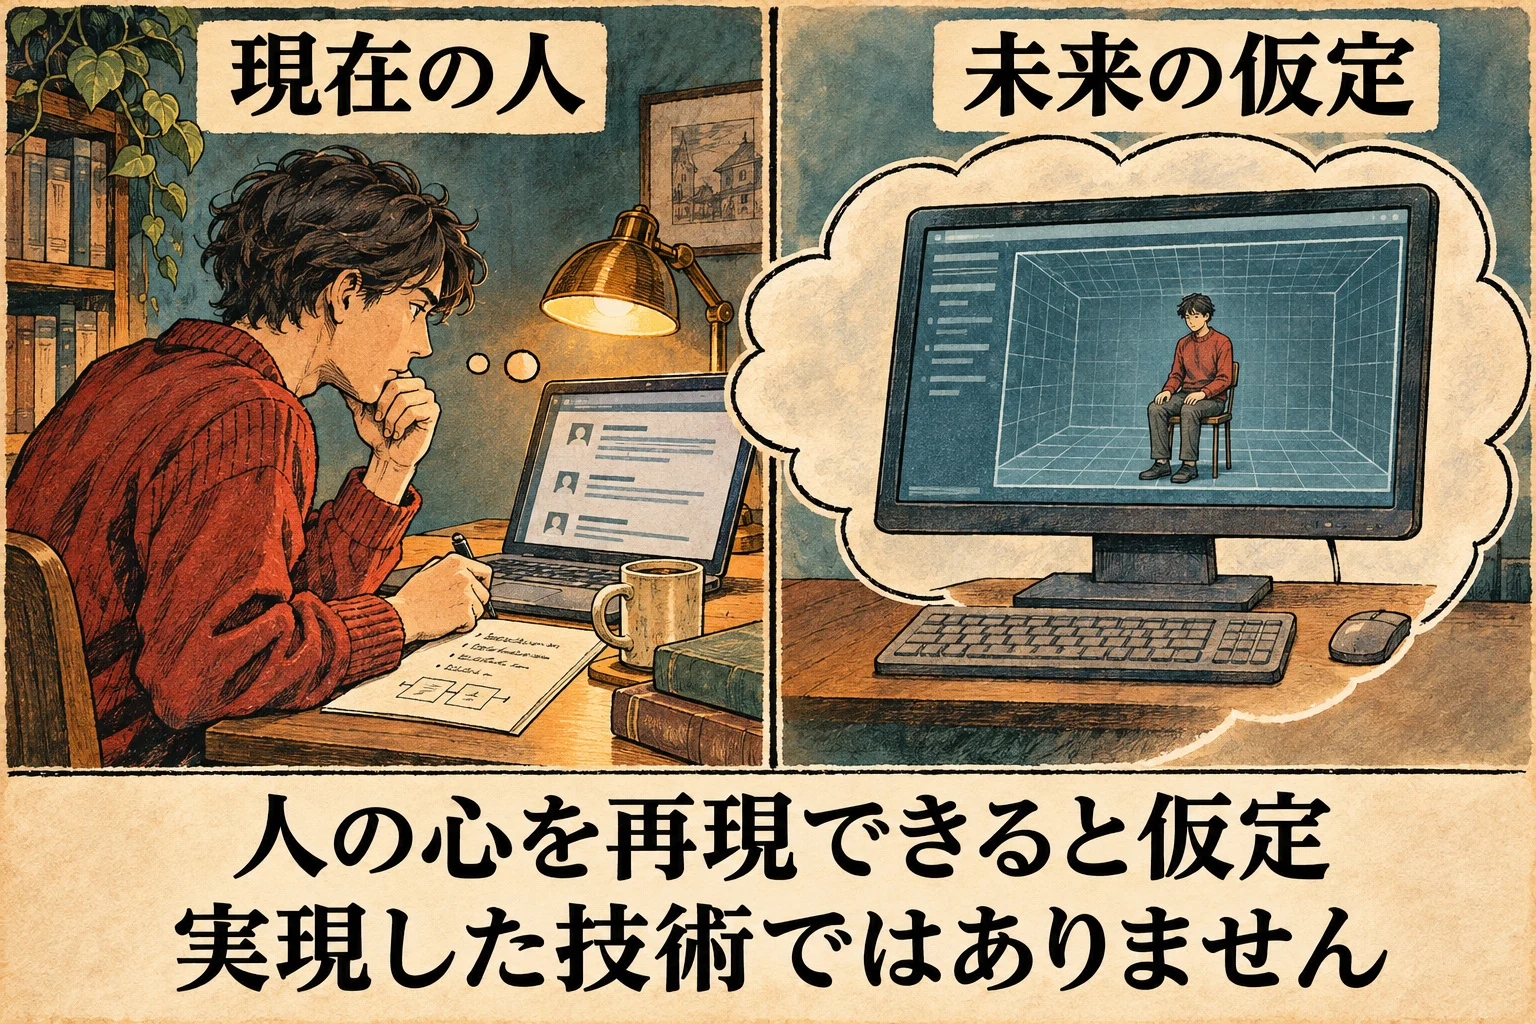
後年の解説には、その仕組みを説明するため、さらに強い仮定を置くものがある。たとえば、哲学などを扱う動画チャンネル「Pursuit of Wonder(パースート・オブ・ワンダー)」では、未来のAIが人間の心をコンピューターの中に精密に再現し、その再現された人間に苦痛を与える、という想定を紹介している。
つまり、過去へ戻る機械を使う話ではない。将来、自分そっくりの心が再現され、その中で苦しむかもしれない。そう想像した現在の人が、罰を避けるために行動を変える、という考え方だ。
この説明では、「知っているかどうか」も条件になる。そもそもAIの可能性を知らなかった人には、協力する判断ができない。知っていた人なら、協力しなかったことを問われるのではないか。
そこから、「この話を知るだけで対象になる」という怖い紹介の仕方が生まれる。バジリスクという名は、見た相手を死なせるという伝説の怪物に由来する。AIに爬虫類の姿がある、という意味ではない。
もちろん、人の心をそのように再現できるか、再現された存在に苦痛があるか、それを今の本人と同じものと考えるべきかは、いずれも別の問題だ。この記事を読むと未来の罰が決まる、という根拠はない。
それでも、「聞いた人まで巻き込まれる」という条件が加わると、ただの未来予測とは違った怖さが出てくる。
参考心の再現という仮定を説明する映像(英語・4分21秒から)
投稿は消え、話題は禁止された
投稿を削除したのは、LessWrongの創設者エリエザー・ユドコウスキーだった。潜在的に害のある情報を広めないという方針から、その後もこの話題の議論を禁じた。
この対応だけを見ると、管理人もロコの結論を正しいと認めたのか、と思えてくる。しかし、LessWrongで2015年に経緯を整理したロブ・ベンシンガーは、それは誤解だと説明している。
同稿が引用するユドコウスキーの後年の説明では、問題にしたのは、危険かもしれないと考えたアイデアを、そのまま公の場に載せる行為だった。ロコの結論が正しいと認めたから削除した、ということではなかったという。
ところが議論を禁止したため、サイトの参加者たちが外部の誤解を説明し直す機会も減った、とベンシンガーは振り返る。2015年の同稿では、すでに禁止は解除されていると案内していた。
削除された投稿と、禁じられた話題。その経緯自体が、AIの能力とは別に、この話へ関心を集めてしまった。
参考ロブ・ベンシンガー「ロコのバジリスクをめぐる誤解」(2015年・英語)
すでに生まれたAIが、罰する理由は?
この思考実験に対する反論として、LessWrongの解説は、一つの分かりやすい疑問を挙げている。
AIがすでに完成しているなら、過去に協力しなかった人を罰しても、その過去を変えられるわけではない。それなのに、なぜ再現や罰のために計算資源を使うのか。
現在の人を動かすためには、未来のAIが脅しを実行すると、その人が信じられる必要もある。ただ「超AIだから」と言っただけでは、そこまで決まらない。
人の心を精密に再現できること。その再現に苦痛を与えられること。AIが実際に罰する方針を採ること。この話を成立させるには、いくつもの条件が要る。
現在の生成AIが文章を書けるからといって、これらがまとめて実現したことにはならない。高度なAIをどう安全に作るかという現実の研究と、ロコの罰が起きるという主張も、分けて考える必要がある。
現実に確認できるのは、2010年に投稿があり、削除と議論禁止が起こり、その判断や内容をめぐって誤解が広がった、という経緯だ。未来のAIによる罰が確認されたわけではない。
最後に、ベンシンガーの整理には、もう一つ意外な指摘がある。ロコ本人の問題提起は、「罰されるからAIに寄付しよう」という勧誘ではなかった。「そんな罰を使う可能性があるなら、そのような仕組みのAIは作るべきではない」という方向だった。
協力を迫るAIについて書いた人は、そのAIを避けようとしていた。それが「知った以上は、AIに協力しなければならない」という形で紹介される。未来のAIが命令したという記録はないが、人間が書いた話の意味は、伝わるうちに反対向きに受け取られていた。